开场
音乐人能把哪些活交给 Agent?
Agent 能读写你电脑上的文件、运行程序、上网查资料,还能操作软件界面。所以凡是输入清楚、结果能检查的活,都可以交给它;审美判断留给你。点一个场景,看一句话交代下去之后,它会怎么做、你会拿到什么。
把 录音/ 里所有人声干声切掉首尾静音,响度统一到 −16 LUFS,导出 48 kHz 的 WAV,再各出一份 MP3 发给制作人。
- 列出 录音/ 里的文件,确认数量和格式
- 用 FFmpeg 测每条的响度和首尾静音长度
- 批量切除静音、统一响度、转码
- 处理完再测一遍,列出前后的时长和 LUFS 对照表
明天要向场地方介绍我们的演出。用文件夹里的策划案、舞台图和排练照做一份 5 页 PPT,讲清演出概念、现场效果和场地需求。最后一页列出需要对方确认的事。
- 从策划案提取演出安排和场地需求
- 挑选排练照,把舞台图和设备要求排在同一页
- 生成可编辑的幻灯片,导出 PDF 供预览
搜《瘦子》的几个版本,列出歌手、时长,标出哪几个现在能播放。再把我有权使用的那几首统一转成 44.1 kHz WAV,按“歌名_版本_BPM”命名。
- 调用搜索接口,拿到候选版本
- 逐条解析播放地址,记下成功或失败的原因
- 对你有权使用的文件转码、测 BPM
- 按约定规则重命名,生成清单
我排练时总要拖进度条找副歌。给我做个播放器,让我自己圈出段落、起名字,再绑到数字键上。按 2 就循环副歌,下次打开这首歌还记得。
- 给时间轴加上可拖动的循环起点和终点
- 把选区保存为段落,允许改名和绑定快捷键
- 在本机按歌曲保存设置
我在写“AI 作曲作品的听感评测”综述。找近三年的相关论文,每篇用三句话概括方法和结论,按主题分组整理成大纲,每条附出处链接。
- 联网检索论文
- 打开论文页面,读摘要和方法部分
- 按主题归类、去重
- 生成带出处的大纲和参考文献表
把 和声课/ 里这学期的笔记、PDF 和课堂录音整理成按章节的复习手册:每章列核心概念、谱例在哪一页、三道练习题。
- 读笔记和 PDF
- 把课堂录音转成文字
- 按章节合并、去重
- 生成复习手册和练习题
把 solo.mid 转成 MusicXML 乐谱,按降 B 调单簧管移调,检查每小节拍数,标出超出音域的音。
- 读 MIDI,量化节奏、拆分声部
- 生成 MusicXML
- 按降 B 调乐器移调(记谱比实际音高高一个大二度)
- 逐小节检查拍数和音域,列出问题小节
stems/ 里是工程导出的 32 条分轨。按乐器重命名,统一成 48 kHz / 24 bit,检查削波、静音轨和左右声道反相,出一份混音前检查清单。
- 批量读取分轨,识别乐器
- 测峰值、静音和左右声道相关性
- 重命名、统一格式
- 生成检查清单;需要时通过 computer use(让 Agent 截屏、点鼠标操作软件,见选读 A)在 DAW 里建轨、导入
给 FM-1 换个固件,白键就能打鼓
固件决定你按键、转旋钮时乐器怎么响应。社区开发的 SLOOP 给 FM-1 加上了一种玩法:用白键打鼓,再用三条合成器轨叠上贝斯、和弦和旋律。
我习惯用相邻三个白键打底鼓、军鼓和闭合踩镲。能帮我改一下这台琴吗?
读固件源码,追踪一次按键怎样触发鼓声,找到映射位置,写出修改供你审阅。
这门课怎么走:先听懂一首参考曲,再写出自己的 Demo
每一讲都用到上一讲的产出:曲库给分析,分析给播放器和编曲结构,编好的作品给乐谱和人声,最后把整条线上反复做的事存成工具。另有三讲选读:让 Agent 操作 DAW、查文献整理笔记、在本机跑开源的 YuE2。
基础篇 · B1
模型架构:Claude、GPT 怎样生成文字,Suno 这类模型怎样生成音乐
后面所有用法都建立在这一层上。先看清模型这台机器的结构:输入怎么进去,中间经过什么,结果怎么出来。
Claude、GPT 这样的模型,每一步只做一件事:看着前面所有内容,给“下一小块”打分,挑一块接上去,再接着猜下一块。这种一块接一块往下写的方式叫自回归;它用来“看前文”的网络结构叫 Transformer。不少音乐生成模型用的是同样的办法,只是把文字换成了声音。
一张图看完整个架构:从你的一句话,到它写出下一个词
下面是 GPT 这类模型的结构。以“把第 8 小节的鼓改成四下 ___”为例,看模型怎样算出下一个词。点“下一步”逐层看,也可以直接点图里的某一层。
Claude、GPT 都属于这种只往后写的 Transformer。
架构图第 2 层细看:文字和声音怎样切成 token
模型不直接处理“字”或“声波”,而是先切成一个个编号的小块,叫 token。文字大致按词或字切:
(每个模型有自己的切法)
声音也能切成 token:先用一个“神经网络编解码器”把波形压缩成一串编号,每个编号代表极短一段声音的特征。以 Meta 开源的 EnCodec(24 kHz,6 kbps 设置,压缩得比较狠的一档,类似低码率 MP3)为例,每秒切成 75 帧,每帧用 8 层编号描述,1 秒音频 ≈ 600 个 token,一首 3 分钟的歌就是十万个以上。
架构图第 5–6 层细看:按概率挑下一块,接上再来(自回归)
模型读完前面的 token,给词表里每一个候选打一个概率,按概率挑一个接上,再把新的整串送回去猜下一个。下面是一个能动手的玩具版本:它只统计课程旋律和另外五句练习旋律里“前两个音之后接什么”,但生成的循环和大模型一样。
温度调低,分高的候选更占优势,结果更保守、更重复;调高,冷门的音也会被抽到,结果更意外。每接一个音会播放出来。
架构图第 4 层细看:注意力怎样决定“重点看前文哪几个词”
刚才的玩具模型只看前两个音,这正是它和 Transformer 最大的区别。Transformer 每生成一个 token,都会把前面所有 token 过一遍,给每一个算一个“该关注多少”的权重,这个机制叫注意力。下面是预测“把第 8 小节的鼓改成四下 ___”的下一个词时,注意力落在哪里:
注意力和前馈网络一起组成一层,这样的层叠几十层,里面有大量可调的数值,叫参数。GPT-3 有 1750 亿个参数;Claude、GPT-4 这类闭源模型没有公布参数量。
训练和使用:参数在训练时调好,你用的时候不再变
训练是让模型读海量文本,一遍遍练习“猜下一个 token”,每猜一次,就按猜得偏了多少把参数往对的方向挪一点。之后再用指令和人类反馈专门训练,它才学会按你的要求回答,而不只是往下续写。
使用时参数已经定住了。它不会因为和你聊天而学到东西。它看起来“记得”你前面说的话,是因为每发一句,整段对话都会被重新送进去,从架构图第 ① 层再走一遍。新开一个会话,前面的就全没了。有些产品的“记忆”功能,其实是把以前对话的摘要放回上下文里。
模型每一步能看到的全部内容叫上下文。上下文能装下的 token 数有上限,这个上限叫上下文窗口;超出的部分,模型就看不到了。
Suno 这类音乐模型的架构:同样逐个预测,只是 token 换成了声音
文字模型和音乐模型对照:结构相同,只有 token 和最后还原这一步不同
| Claude、GPT | Suno 这类音乐模型(公开的同类做法) | |
|---|---|---|
| 输入 | 你的提示词和之前的对话 | 风格描述、歌词 |
| token 是什么 | 文字的小块 | 编解码器把声音压缩成的小块 |
| 数量 | 一句回答几十到几百个 | 每秒几十到几百个,一首歌几万到十几万个 |
| 中间的结构 | Transformer,逐个预测下一个 token | Transformer,逐个预测下一个声音 token(另一条路线是扩散模型) |
| 最后一步 | token 直接拼成文字 | 编解码器的还原端把 token 还原成波形 |
基础篇 · B2
Agent 怎样完成任务:八个词,各配一个音乐例子
把一段录音拖进 DeepSeek Harness,问它“副歌从哪里开始”。模型会决定先看什么,工具负责读取录音、运行分析程序。结果回到会话里,模型才有依据给出时间点。
从一句要求到一个结果,中间经过哪几层
模型
model在 DeepSeek Harness 里,你把音乐问题交给模型。它决定怎么分析,写出代码,再根据工具返回的结果回答你。
完整的一次分析过程(工具怎么调用、读回什么、怎么修正),放在第 2 讲,学到那里先自己听一遍再看。
常见的模型
收到一段会议录音,你可能想把它转成文字,也可能想从讨论里找出三件待办。前者要识别语音,后者要理解大家说了什么。选模型时,可以先看你手上有什么、想得到什么。
读文字、写代码
把一串聊天记录交给 DeepSeek 或 Claude,让它找出谁答应了做什么。也可以给它一份文件命名规则,请它写个批量改名的脚本。
看图、理解声音
拍下咖啡机的控制面板,问“哪个键能打奶泡?”能看图的 GPT 或 Gemini 可以结合图标回答。能接收多种形式输入的模型,通常叫多模态模型。专门把录音转成文字,则可以用 Whisper 这样的语音识别模型。
生成图片、视频
写下“清晨的面包店,窗上有雾”,图像模型可以据此画出一张图。再把图交给支持图生视频的模型,加一句“镜头慢慢靠近橱窗”,就能试出一个运动镜头。
合成语音、生成音乐
同一句“下一站到了”,语音合成模型可以把它念成车站广播。想把它唱成带伴奏的广告歌,则可以把它当歌词交给音乐生成模型,例如 Suno。
小测:下面这些事,模型自己就能做吗?
点你认为对的那一项,看答案和原因。
提示词与上下文
prompt · context提示词是你这一次写下的要求。上下文是模型做这件事时能看到的全部信息:之前的对话、读过的文件、每一步的执行结果。
提示词体检:从“结尾加点变化”开始,一项一项补齐
一句能交给 Agent 的音乐要求,通常要写清五件事。点下面的按钮逐项加上,看提示词怎么变,以及缺了哪一项时它只能靠猜:
上下文里到底装着什么
工具
tool模型能调用的具体动作:列目录、读文件、运行命令、截屏、点击鼠标。工具执行完,把结果(文件名、数字或报错)交回给模型。
一次工具调用长什么样:模型写一张“工单”,工具交回一张“回执”
模型并不真的“动手”。它只写出一张格式固定的工单:要用哪个工具、参数是什么;Harness 照单执行,再把回执交回模型。下面是课程包里 wav_info 工具一次真实调用的关键字段(为便于阅读已节选):
{
  "method": "tools/call",
  "params": {
    "name": "wav_info",
    "arguments": { "path": "八小节试听.wav" }
  }
}{
"content": [{
"type": "text",
"text": "{\"seconds\": 16.0, \"sample_rate\": 22050, \"channels\": 1, \"frames\": 352800}"
}],
"isError": false
}你在 Harness 界面上看到的“运行了某某命令”“读取了某某文件”,背后都是这样一来一回。常见的工具有:读文件、写或修改文件、运行命令、搜索网页、打开网页、截屏和点击鼠标。每个 Harness 自带哪些、哪些要先经过你同意,各家不同。
Agent
模型 + 工具 + 循环模型 + 工具 + 一个循环:模型决定一步,工具执行,结果回到模型,模型再决定下一步,直到任务完成。能自己把这个循环跑下去的系统,就是 Agent。
和网页版聊天有什么区别:同一个问题,两种回答
| 网页版聊天(ChatGPT、豆包等) | Agent(在 Harness 里运行) | |
|---|---|---|
| 问“八小节试听.wav 有多长” | 它看不到你电脑上的文件,只能让你上传,或者根据你的描述推算 | 自己去课程文件夹里找到文件,运行命令读出 352800 帧 ÷ 22050,回答 16.0 秒 |
| 能碰到的东西 | 你贴进来的文字、上传的文件 | 工作目录里的所有文件 |
| 能不能运行你电脑上的程序 | 不能(有的能在网页服务器上跑代码,但那不是你的电脑) | 能:FFmpeg、Python、MuseScore 命令行…… |
| 做错了怎么办 | 你自己发现、自己改 | 它能看到报错,自己换办法再试 |
一句话:网页聊天只有“模型”这一层;Agent 是模型加上工具和循环,所以能真的去干活,也因此要管好它能碰哪些东西(见 Harness)。
Harness
运行 Agent 的外壳把模型变成 Agent 的那层外壳:它决定模型能用哪些工具、在哪个目录里工作、什么操作要先经过你同意,并把每一步记录下来给你看。
| DAW 宿主提供给插件的 | Harness 提供给模型的 |
|---|---|
| 插件插在哪条轨道上 | 在哪个工作目录里干活 |
| 输入输出路由 | 可以调用哪些工具 |
| 自动化与撤销历史 | 运行记录:每一步做了什么、得到了什么 |
| 保存工程 | 保存会话和上下文 |
| 安全设置(防止爆音) | 权限设置:删除文件、联网等操作要先问你 |
四款 Harness:怎么装、怎么登录、花多少钱
| DSH | WorkBuddy | Claude Code | Codex | |
|---|---|---|---|---|
| 出品 | DeepSeek,开源 | 腾讯云代码助手团队 | Anthropic | OpenAI |
| 不用终端的入口 | 桌面端(Mac 仅 Apple 芯片、Windows) | 桌面客户端,另有手机 App | 桌面 App、网页版 | ChatGPT 桌面 App、网页版 |
| 首次登录 | 不用账号,填 DeepSeek API Key | 微信扫码 | claude.ai 账号 | ChatGPT 账号 |
| 费用 | 软件免费,模型按用量付费 | 免费版每月 500 积分;付费 99 元/月起 | Pro 20 美元/月起 | 有免费档;Plus 20 美元/月 |
| 权限选项 | 仅可查看 / 工作区内修改 / 完全权限 | 默认权限 / 允许完全访问 | Manual、acceptEdits、plan、auto 等 | Ask for approval / Approve for me / Full access |
| 改错了怎么回退 | 先备份 | 改文件前自动备份 | /rewind 回到之前的存档 | 官方建议先做 Git 存档 |
| 项目说明文件 | AGENTS.md / CLAUDE.md | CODEBUDDY.md / AGENTS.md | CLAUDE.md(也认 AGENTS.md) | AGENTS.md |
本课默认用 DSH:模型可换、按用量付费,装法和确认框见第 0 讲。不想碰 API Key、平时主要用桌面软件,可以用 WorkBuddy;已有 Claude 或 ChatGPT 付费订阅,可以直接用 Claude Code 或 Codex。概念都一样,按钮位置不同。
API
程序之间的约定接口程序和程序之间约定好的对话方式:往哪个地址发请求、带什么参数、会收到什么格式的数据。
请求  GET /cloudsearch?keywords=瘦子
单曲 瘦子 丁世光 2132838764 165424 毫秒
专辑 背面是我 丁世光 2659586244 165424 毫秒
歌名、艺人和时长相同,发行条目的 ID 不同。第一讲选单曲版的 ID 请求下载地址。
把一条 API 地址拆开看
http://用什么方式通信127.0.0.1找哪台电脑:这台就是你自己的电脑:18741敲哪扇门:一台电脑上有很多服务,靠端口号区分/cloudsearch办哪项业务:搜索?keywords=瘦子业务要的参数:搜什么返回时先看状态码:200 是办成了,404 是没有这项业务(地址写错),502 是本地服务去找上游时出了问题。音乐软件之间也到处是 API:Suno 这类生成服务、网易云的搜索、你在第 3 讲做的播放器,都是这样一问一答。
MCP
Agent 接工具的通用协议一套让 Agent 接入外部工具的通用协议。工具按 MCP 的约定说明“我叫什么、要什么输入、返回什么”,任何支持 MCP 的 Harness 就都能直接使用它。
Harness 怎么知道有这个工具:先握手,再要说明书,最后调用
第 2 步拿到的说明书,就是下面这段(课程包里的工具真实返回)。Harness 把它交给模型,模型读了“读取一个 WAV 文件,返回时长……”这句描述,才知道遇到“这个 WAV 多长”时可以用它:
{
  "name": "wav_info",
  "description": "读取一个 WAV 文件,返回时长(秒)、采样率(Hz)、声道数和帧数。只支持 PCM 编码的 WAV。",
  "inputSchema": {
    "type": "object",
    "properties": {
      "path": { "type": "string", "description": "WAV 文件路径,相对路径按工作目录解析" }
    },
    "required": ["path"]
  }
}
所以写 MCP 工具时,描述那一句最重要:写不清,模型就想不到用它。
Skill
写给 Agent 的做事方法一份写给 Agent 的做事方法:什么情况下用、按什么步骤做、怎样检查,可以附带脚本。支持 Skill 的 Harness(例如 Claude Code)平时只读它的名字和简介,遇到相关任务才把全文读进上下文;DSH 也一样,Skill 放在项目里的 .dsh/skills/ 或 .agents/skills/。
工具/skills/export-ab-preview/
├── SKILL.md          ← 说明:何时使用、要确认什么、步骤、怎么核对
└── export_ab.py      ← 固定动作写成脚本:截取、转码、核对

# SKILL.md(要点缩写,完整文件在课程包里)
---
name: export-ab-preview
description: 导出两版供试听。需要把同一首曲子的两个版本截出相同的
  小节范围、导出给别人对比试听时使用。
---
## 开始前要确认的四件事(缺一项先问用户,不要猜)
1. 输入:两个音频文件,以及各自的版本名(默认 A、B)
2. 范围:起止小节,以及速度和每小节拍数
3. 输出:WAV(编辑、精确对齐)+ MP3(快速试听)
4. 核对:两个 WAV 时长都等于计算值;MP3 略长几十毫秒属正常
name 用小写英文和连字符,与文件夹同名,这是 Claude Code 等 Harness 的通行写法;说明正文可以用中文。
装没装 Skill,同一句话的差别
用户说:“把 A 和 B 的第 7–8 小节导出来给同学听。”下面是两种典型做法的示意:
- 直接猜速度,按 120 BPM 从 14 秒开始截(错了一小节)
- 只导出 WAV,文件名叫 output1.wav、output2.wav
- 回答“已完成”,没有核对时长和起点
- 先问:速度多少?每小节几拍?导出到哪里?
- 算出第 7 小节从 12 秒开始,导出 WAV 和 MP3,文件名带版本和小节
- 报告核对结果:两个 WAV 都是 4.000 秒,采样率一致
Skill 什么时候被读进上下文
术语速查
| 词 | 它是什么 | 谁来用 | 本课在哪里出现 |
|---|---|---|---|
| 模型 | 读写文字、做决定 | Harness 调用 | 每一讲 |
| Transformer / 自回归 | 模型的架构:逐个预测下一块(B1) | 模型内部 | 理解为什么要核对、要 A/B |
| 提示词 / 上下文 | 你的要求 / 它能看到的全部信息 | 你写,模型读 | 第 0 讲起 |
| 工具 | 具体动作 | 模型调用 | 第 0、2、4、8、9 讲 |
| Agent | 模型 + 工具 + 循环 | 你交任务给它 | 每一讲 |
| Harness | 运行 Agent 的外壳 | 你直接操作(DSH) | 第 0 讲起 |
| API | 程序之间的约定接口 | 程序调用 | 第 1、3、5 讲 |
| MCP | Agent 接工具的通用协议 | Harness 和工具 | 第 9 讲 |
| Skill | 写好的做事方法 | Agent 按需读取 | 第 9 讲、选读 B |
一句话串起来:你在 Harness 里写提示词;模型结合上下文决定下一步,调用工具执行,这个循环就是 Agent;工具可以通过 MCP 接入,访问在线服务时走 API;反复用的做法写成 Skill,下次直接调用。
开工前
装好 DSH,选好工作区,发出第一句话
下面每一讲都在 DSH 里完成。先把它装好、指到课程文件夹,并确认它弹出确认框时你知道该点什么。
第 0 讲
装好 DSH,把课程文件夹设为工作区,确认它能读到素材
- 目标
- 装好 DSH,把课程文件夹设为工作区,知道确认框该怎么点
- 产出
- DSH 能列出课程包里的素材,并读出 八小节试听.wav 的时长
两种装法:桌面端不用终端,网页版要先装 Node.js
- 到 deepseek.com/harness 下载安装包:Mac 只有 Apple 芯片版(.dmg),Windows 是 x64 版(.exe)。
- 安装后打开,第一次会出现填写 API Key 的页面。
- 装 Node.js 24.9 或更新的版本(nodejs.org)。
- 在终端里进入课程文件夹,运行
npx @deepseek-ai/dsh web。 - 浏览器打开
http://127.0.0.1:3080。
填 DeepSeek API Key:设置 › 模型
DSH 软件本身免费,模型按用量付费。到 platform.deepseek.com 注册、充值并创建 API Key,然后在 DSH 里打开 设置 › 模型,在 DeepSeek 卡片里粘贴并保存,不用重启。Key 相当于付费账号的密码,不要贴进对话或发给别人。
选择工作区:选好之前,输入框是灰的
网页版刚打开时不会自动选工作区。点 选择工作区,添加课程文件夹并选中它,输入框才能用。用命令行启动时,启动所在的文件夹就是工作区,所以要先 cd 进课程文件夹再运行。
权限选“工作区内修改”;确认框先点“允许一次”
| 权限 | 意思 | 本课建议 |
|---|---|---|
| 仅可查看 | 只能读,不能改文件(出厂默认) | 第一次打开时可以先用它试着提问 |
| 工作区内修改 | 能在课程文件夹里写文件,越界的操作会弹确认框 | 本课用这一档 |
| 完全权限 | 不受限制,也不再询问 | 不要开 |
它要执行命令或改文件时,会弹出确认卡片,按钮是“允许一次”“始终允许”“拒绝”。前几讲一律先读它要运行的命令,再点“允许一次”。读文件、运行 python 读取参数,可以放行;看到删除(rm、del)、覆盖课程包原文件、安装来路不明的软件,先点“拒绝”,问它为什么需要这样做。
AGENTS.md:Agent 每次开工前先读的项目说明
课程包根目录有一份 AGENTS.md,写着素材规格(120 BPM、4/4、鼓轨在第 10 通道)和规矩(不覆盖原文件、报数字要给出实际命令和输出)。DSH 会自动读这份文件,所以这些条件不用每次写进提示词。你自己的项目也可以写一份。
只在需要时用终端:打开、进入文件夹、运行一条命令
- 按 ⌘ + 空格,输入“终端”,回车。
- 输入
cd(后面有空格),把课程文件夹从访达拖进窗口,回车。 - 输入
ls回车,能看到 八小节试听.wav 等文件,就说明进对了。
- 按 Win 键,输入“终端”或“PowerShell”,回车。
- 输入
cd,把课程文件夹拖进窗口,回车。 - 输入
ls确认。课程里的python3在 Windows 上换成python。
大部分命令 DSH 会替你运行。你需要自己敲的,主要是启动网页版和第一讲的播放器服务。按 Ctrl + C 停止正在运行的命令。
课程包里的文件,各用在第几讲
解压后先把整个文件夹复制一份留作原版,练习只在另一份里做。
| 文件 | 内容 |
|---|---|
AGENTS.md | 给 Agent 看的项目说明:素材规格和规矩 |
说明.txt | 文件清单和启动播放器服务的步骤 |
library/ | 十首 CC BY 器乐曲(Kevin MacLeod)、封面和段落标注,第 1、3 讲用 |
播放器服务/ | 第 1、3 讲的本地网易云服务(Node.js 18 及以上) |
参考播放器.html | 第 3 讲的参考成品,双击即可打开 |
八小节练习.mid | 你的小样起点(第 4 讲起):旋律轨 + 鼓轨,120 BPM,4/4,每四分音符 480 tick |
八小节试听.wav | A 版音频:22050 Hz,单声道,16 秒 |
八小节鼓花B.mid | B 版 MIDI,参考答案:只改第 8 小节第 3–4 拍 |
八小节鼓花B.wav | B 版音频,参考答案 |
三十二小节参考.mid / .wav | 第 5 讲的参考编排:四段,64 秒 |
乐谱/ | 第 6 讲的 MusicXML:八小节旋律 + 低音,另有一份带“前四小节反复”的版本 |
歌声对照/ | 第 7 讲“窗”一字跨两音的对错两版 |
工具/ | 第 9 讲的 MCP 工具 wav_info_mcp.py 和 Skill skills/export-ab-preview/;选读 B 的引用核对脚本 check_refs.py 和 Skill skills/study-handbook/ |
研究与整理/ | 选读 B:一份含错误引用的参考文献表,三周和声课笔记(里面藏了一处错误) |
所有音频由程序合成,保证所有人听到的对照一致。MIDI 轨道名用英文(Melody、Drums 等),因为不少 DAW 读不了中文轨道名。换成自己 DAW 里的鼓组,音色会变,要改的拍位不变。练习前先另存,原版始终留着做对比。
让 DSH 检查这台电脑缺什么
自检:让它列出素材,读出一个 WAV 的时长
把解压后的课程文件夹设为 DSH 的工作目录。接下来它就能在里面找素材、运行工具,把做好的文件交还给你。
它应该报告:22050 Hz、单声道、16.0 秒,并贴出读取命令。只给出“16 秒”却没有命令,说明它是推算的,不是读出来的:让它重新运行一次。
第一部分 · 听
听懂一首参考曲:找到它、分析它、做成练习工具
先听别人的歌。建一个参考曲库,让 Agent 分析一首歌的速度、调性和段落,再把分析结果做成一台能按段落循环的播放器。
第一讲
建一个参考曲库:用网易云 API 找歌、取音源,再加上课程自带的曲库
你在网易云 App 里搜“瘦子”,屏幕上会列出好几首歌。这个搜索框背后就有一次 API 调用:播放器把关键词发出去,音乐服务把歌名、艺人和歌曲编号发回来,播放器再把这些结果排成列表。
参考曲从两处来:课程包 library/ 里自带十首 CC BY 授权的器乐曲(Kevin MacLeod 作品,可以自由使用,第 3 讲的播放器直接读它);你想研究的商业歌曲,用自己的网易云账号在本机获取。这一讲先学会用 API 找到并取回一首歌。
先启动课程包里的本地网易云服务
第一次会先安装依赖,要一两分钟。服务启动后,那个终端窗口不要关;关掉它,服务就停了。
从搜到一首歌,到听见它
API 是程序之间约定好的问答方式。这门课用社区项目 NeteaseCloudMusicApi 在你的电脑上启动一个本地服务。Agent 和你写的播放器都可以向它发请求,由它去和网易云音乐通信。
- 搜歌曲
- 发出关键词“瘦子”,从结果中选丁世光的单曲版。它的歌曲 ID 是
2132838764。接下来播放或下载,都用这个编号指明是哪一版。 - 搜歌单
- 关键词换成“夜跑”,搜索类型选“歌单”,拿到的是一组歌单。点开其中一个,用歌单 ID 取出曲目,每首歌又有自己的歌曲 ID。
- 在线播放
- 点击播放时,播放器拿歌曲 ID 请求播放地址,再让浏览器从这个地址读取音频。搜索结果负责告诉你“是哪首歌”,播放地址负责让它响起来。
- 下载歌曲
- 登录后,下载脚本用同一个歌曲 ID 请求下载地址。账号有下载权限时,脚本就能沿这个地址把音频保存到电脑,交给下一讲做分析。
知道这些接口能做什么,你就可以用自己的话交代任务。比如“我要拿丁世光的《瘦子》做听辨练习”,Agent 会去查;如果有几个发行版本,你看一眼专辑和时长,再决定用哪一版。
找到单曲版
本次查到单曲《瘦子》和专辑《背面是我》两个条目。单曲 ID 是 2132838764;两条的标称时长同为 165424 毫秒。
用自己的账号扫码下载
这次匿名调用下载接口返回 -105;扫码后取得 MP3,完整解码时长约 2 分 45.4 秒。每位学生使用自己账号的权限。课堂包提供工具,商业录音由学生在本机获取。
给下一讲留一份匿名音频
你来判断 打开下载文件,听开头的人声和伴奏是否是你选的版本。再看听辨文件夹,交给下节课的文件名应是“片段.wav”。
第二讲
这首歌有多快,落在哪个调上,从哪里换段?
先听第一遍,在纸上记三个东西:你会跟着哪一下打拍子,哪一个音听起来最安稳,第一次明显的配器或唱法变化出现在什么时候。先留下自己的判断,再打开 DSH,新建会话,选中上一讲的“听辨练习”目录。
让 Agent 做一次不看曲名的分析
把结论放回声音里
速度。 BPM 说的是你选哪一层脉冲来数拍。鼓的细分和军鼓重音都可能给出稳定周期。挑一段节奏清楚的地方,连续数八拍,把第一拍到第九拍的秒数除以八。用 60 除以这个拍间距,再与 Agent 的候选比对。
调式与调性。 音级分布能提示使用了哪些音;主音还要结合低音走向、旋律停留和乐句收束。两个关系大小调共享音级时,让 Agent 指出某一个具体乐句为什么更像落在其中一个主音上。有离调和弦时,单独讨论那几拍。
结构。 在它标出的每个边界前后各听四秒。鼓组进入、低音变密、同一段主唱旋律重现,分别支持不同的划分。先用“人声进入”“重复主题”等可回听的描述,再决定要不要叫它主歌或副歌。
它实际怎样分析这首歌?
DSH 先用终端确认工具可用,再写 Python 脚本调用 librosa。它从声音的起音间隔估算速度,用低音和十二个音级的分布比较调性,又把频谱、重复段和各频段能量画成图,读图后才整理段落。第一次提取音高峰时阈值过高,一项也没找到,它降低阈值重算。这里能看到 Agent 的工作循环:执行一个测量,读回结果,再决定下一步。
回放:DSH 分析这段录音的实际过程
片段.wav
输出 · 分析报告摘要
BPM 161.5。跟着慢一层的脉冲数拍,约为 80.8 BPM。
Key 模型倾向 A 多利亚调式。若把 D 听作主音,同一组音也支持 D 混合利底亚调式。
段落结构 前奏之后逐渐铺开,约 0:36 进入主段。中间有两次短暂的停顿或过渡,约 2:27 转入变奏,最后收尾。
展开段落时间轴
0:00–0:14前奏0:14–0:36建立段0:36–1:01主段 A1:01–1:03短暂停顿1:03–1:25主段 B1:25–1:29滤波过渡1:29–2:11主段 C2:11–2:27主段 D2:27–2:38变奏2:38–2:45收尾
音乐专用模型和通用模型,各听出了什么?
把同一份匿名录音交给两个模型,都问速度、调性和段落。下面是它们对《瘦子》的回答摘要。
| Music Flamingo音乐理解模型 | Gemini 4 Argon通用多模态模型 |
|---|---|
| 速度与调性 | |
| 81 BPM · G 大调 | 80 BPM · G 大调 也提出了 E 小调的解释。 |
| 低音从哪里来? | |
| 认为低频主要来自木吉他的低音弦。 | 认为约 0:37 有电贝斯随鼓组加入。 |
| 副歌从哪里开始? | |
| 描述了主歌、导歌到副歌的推进,提到副歌人声更饱满,没有标出起点。 | 把第一段副歌标在 1:02–1:28,理由是停顿后人声音区升高、和声变厚。 |
上面的回放里,DSH 说“A 多利亚”;这里两个模型都说“G 大调”。两者用的是同一组音,分歧在把哪个音听成主音,正好用 0:37 前后的低音来判断。两份回答的速度只差 1 BPM,真正值得听的是低音。带着“吉他的低音弦”和“新进来的电贝斯”这两种解释,从 0:37 前几秒开始放:鼓进来以后,低音有没有弹出一条独立于吉他的线?
换一首你熟悉的歌
给两个模型上传同一段录音,分别复制这句提问。挑一处它们说得不一样的地方,跳过去听。
你来判断 从模型标出的段落边界前几秒开始听,试着说出哪一层声音进来或退去。能指出时间和变化,再给这段命名。
第三讲
把第 2 讲的分析做成一台按段落循环的练习播放器
- 目标
- 让 DSH 写一台读曲库、按段落跳转和循环的网页播放器,并学会验收
- 产出
- 我的播放器.html:能选曲、点段落跳转、循环一段,给自己的歌加段落标记
扒歌、练琴、排练时,最费时间的是来回拖进度条找副歌。上一讲你已经知道一首歌在哪里换段,这一讲把这张段落表变成一台点一下就能跳、按一下就能循环的播放器。
先看成品:选一首,点段落,听它跳到哪
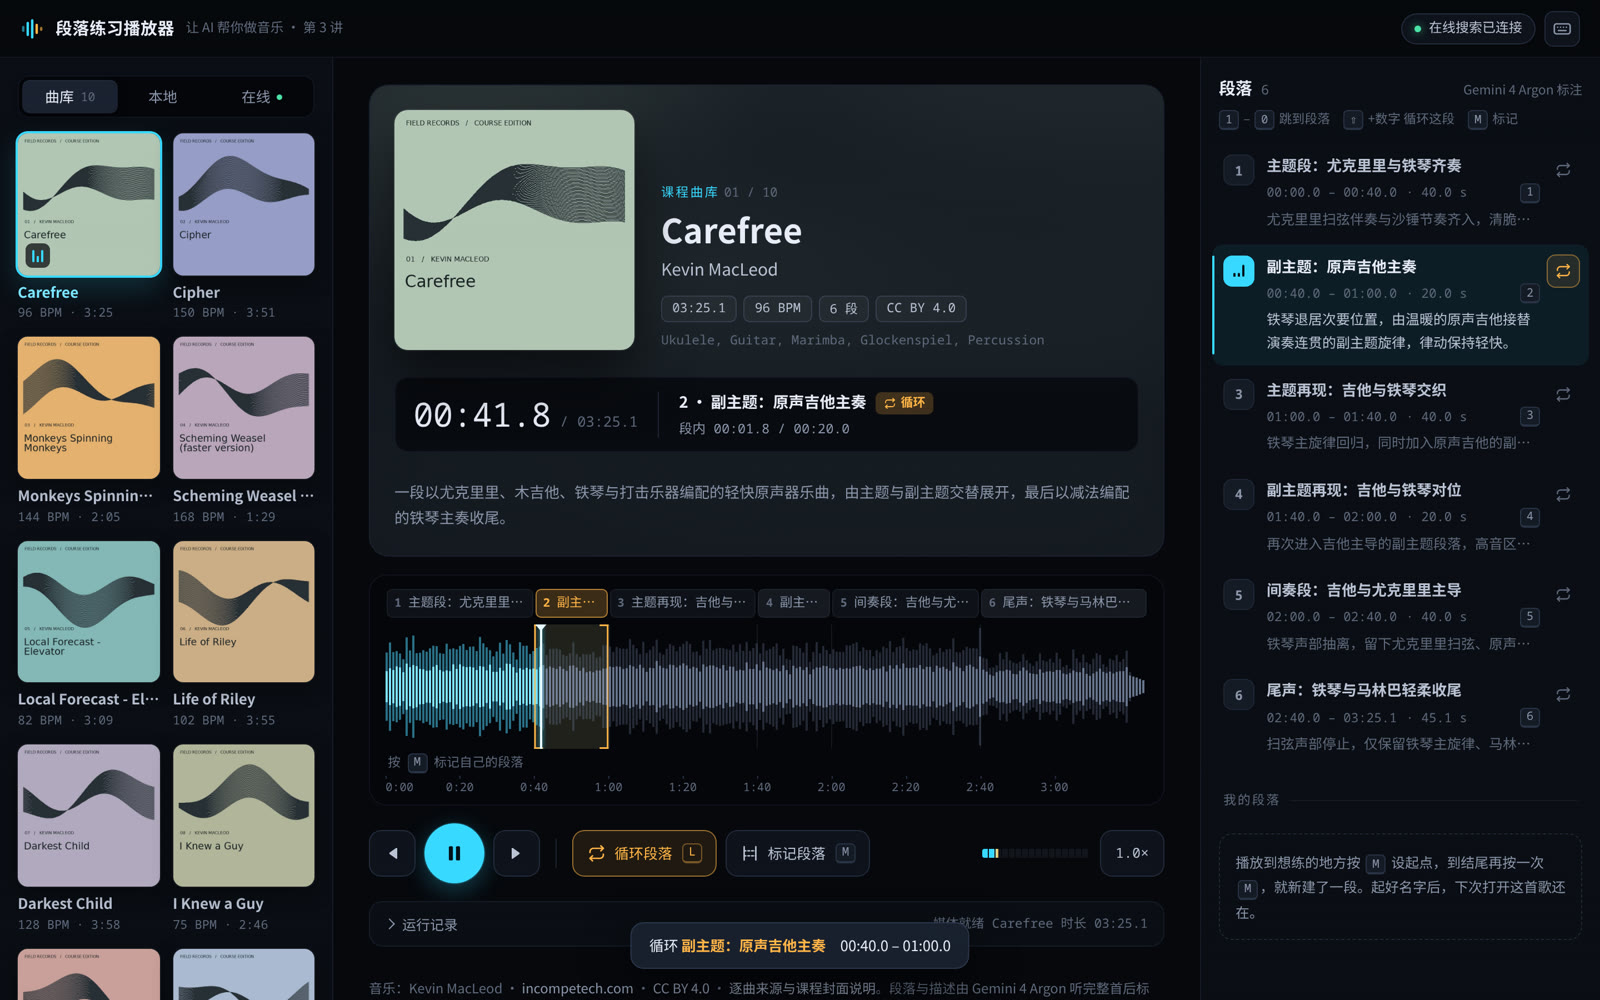
打开课程包里的「参考播放器.html」,选一张封面,点第二个段落,看播放头跳到对应起点;再换一首,段名和听感描述也会换。打开参考播放器 →
曲库里有十首完整器乐录音、封面,以及 Gemini 4 Argon 听完整首后给出的中文段落描述。每段都带起止秒数、段名和听感描述,都在 library/ 文件夹里,你的播放器可以直接读取。
第一轮:让 DSH 读曲库,做出按段落跳转的播放器
验收:挑一首你没听过的曲子,从中段的某个段落开始听,留意描述里的乐器或节奏变化是不是真的在这里出现。如果你听见它晚了两秒,告诉 Agent 要改哪首、哪段、哪个起点。标注是模型听出来的,你的耳朵是最后一关。
第二轮:把第 2 讲那首歌的段落表接进来,绑上数字键
曲库的段落是现成的。第 2 讲你让 Agent 分析了 片段.wav,得到一张段落表(分析.txt),并且自己回听修订过。把它接进播放器:
出了问题,按“操作 + 期望 + 实际”告诉它
不需要看懂代码。点一首歌到出声,页面里要经过四步:读到音频文件、生成可播放的地址、交给 audio 元素解码计时、在列表里标出当前曲目。列表里标题变了,不等于声音换了,所以验收时同时看标题、看时间、听声音。发现问题时这样说:
第三轮:接上第一讲的本地服务,在播放器里搜歌
第一讲你在对话里请 Agent 找歌。这次让它把同样的能力接进播放器,你来决定搜索结果怎么排、点哪里开始播。
你来判断 选一首曲库里的歌,按数字键在段落之间跳三次,听每次是不是落在段落开头;再给第 2 讲那首歌的副歌存一个标记,关掉页面重新打开,看还能不能直接跳回去。
播放器留着。下一讲开始写你自己的小样,之后每改出一个版本,都可以拖进来,从同一个段落对比着听。
第二部分 · 写
写自己的小样:精确修改、按参考曲的结构扩写、出谱
从一段八小节动机开始,写成自己的作品。第 2 讲分析出的段落结构,就是这里扩写的蓝本。
第四讲
在 MIDI 里把第 8 小节第 3–4 拍改成四下军鼓
- 目标
- 理解 MIDI 事件的音高、时间与力度;手动和用 Agent 各完成一次鼓花修改
- 产出
- 改好的 B 版 MIDI,以及改前改后的鼓轨事件对照
前三讲听的是别人的歌。从这一讲开始写你自己的:课程包里的 八小节练习.mid 是一段八小节动机,就当作你小样的起点(也可以换成你自己的 MIDI)。先练最基本的一件事:精确地改一处,并确认别处没有变。
MIDI 存的是“哪个音、何时按、多重”,不存声音
打开 八小节练习.mid,编辑器会显示 Melody(旋律)和 Drums(鼓)两条轨。MIDI 文件描述的是一系列随时间发生的事件:某个时刻按下某个音,带着一个力度;过一段时间松开。用什么音色发声,由 DAW 决定。把旋律轨换成电钢琴,音符位置没动,声音变了。
交付时把 MIDI 和参考音频放在一起:对方可以用 MIDI 接着改音符,也可以听音频确认你选的音色。
旋律升两个半音:C E G E 变成 D 升F A 升F
旋律第一小节依次是 MIDI 音高 60、64、67、64。十二平均律中相邻整数相差一个半音,这四个音是 C、E、G、E。下面是前两小节的钢琴卷帘,试试整体移调:
交给 Agent 时要写明“仅旋律轨整体上移两个半音”。通用 MIDI 鼓组用不同的音高编号对应不同的打击乐器,鼓轨如果也加 2,底鼓(36)就变成了军鼓(38)。这套编号只在第 10 通道生效,课程包的鼓轨就在第 10 通道(有些软件从 0 数,显示为通道 9)。
第 8 小节第 3 拍 = tick 14400
课程包的 MIDI 每个四分音符为 480 tick,4/4 拍下一小节是 1920 tick。第 8 小节第 3 拍:前七个完整小节 7 × 1920 = 13440,再走两拍 2 × 480 = 960,合计 14400。在这里放四颗八分音符军鼓,每颗 240 tick:
| 拍位 | 起点 tick | 终点 tick | 时间 | 力度 |
|---|---|---|---|---|
| 8.3 | 14400 | 14640 | 15.00 s | 70 |
| 8.3 后半拍 | 14640 | 14880 | 15.25 s | 80 |
| 8.4 | 14880 | 15120 | 15.50 s | 90 |
| 8.4 后半拍 | 15120 | 15360 | 15.75 s | 105 |
最后一颗结束于 15360,正好是乐句终点。只会看钢琴卷帘也没关系:把网格设为八分音符,从“8.3”开始数四格,是同一件事。
用钢琴卷帘看鼓花改在哪里
横向看四颗音是否等距,纵向看它们是否还在同一行军鼓上。再看力度条是不是逐颗升高。
让 DSH 改,并列出改前改后的鼓轨事件
Python 自带的工具读写不了 MIDI,DSH 很可能请求安装 mido(读写 MIDI 的常用库),可以允许。如果报 externally-managed-environment,让它建一个虚拟环境再装。
MIDI 文件里每个事件记的是“距上一个事件过了多少 tick”。插入或删除一个事件,紧跟在它后面那个事件的间隔就要重算,单看间隔很容易看错。所以比较时要把间隔累加成绝对 tick,看事件在歌曲里的实际位置。就像谱上只写“休止几拍再弹”,而不写“第几拍弹”:中间插进一个音,紧跟着的那个“休止几拍”就得重算。
下面是从课程包两个文件里直接导出的第 8 小节鼓轨事件。“相对间隔”是文件里实际存的数字,“绝对 tick”是从头累加出来的位置:
| 绝对 tick | 相对间隔 | 音符 | 音高 | 力度 |
|---|---|---|---|---|
| 13440 | 240 | 开 | 36 底鼓 | 100 |
| 13680 | 240 | 关 | 36 底鼓 | — |
| 13920 | 240 | 开 | 38 军鼓 | 90 |
| 14160 | 240 | 关 | 38 军鼓 | — |
| 14400 | 240 | 开 | 36 底鼓 | 100 |
| 14640 | 240 | 关 | 36 底鼓 | — |
| 14880 | 240 | 开 | 38 军鼓 | 90 |
| 15120 | 240 | 关 | 38 军鼓 | — |
八小节练习.mid(A)
| 绝对 tick | 相对间隔 | 音符 | 音高 | 力度 |
|---|---|---|---|---|
| 13440 | 240 | 开 | 36 底鼓 | 100 |
| 13680 | 240 | 关 | 36 底鼓 | — |
| 13920 | 240 | 开 | 38 军鼓 | 90 |
| 14160 | 240 | 关 | 38 军鼓 | — |
| 14400 | 240 | 开 | 38 军鼓 | 70 |
| 14640 | 240 | 关 | 38 军鼓 | — |
| 14640 | 0 | 开 | 38 军鼓 | 80 |
| 14880 | 240 | 关 | 38 军鼓 | — |
| 14880 | 0 | 开 | 38 军鼓 | 90 |
| 15120 | 240 | 关 | 38 军鼓 | — |
| 15120 | 0 | 开 | 38 军鼓 | 105 |
| 15360 | 240 | 关 | 38 军鼓 | — |
八小节鼓花B.mid(B)
看 B 版 14640 那一行:一个军鼓刚“关”,下一个军鼓在同一时刻“开”,所以相对间隔是 0。只看相对间隔,很难一眼看出这是第 8 小节第 3 拍后半拍;换算成绝对 tick 就清楚了。高亮的是从第 3 拍(14400)开始改动的部分。
改完与课程包里的 八小节鼓花B.mid 对照,再导出声音听一遍:事件全对,也可能配了错误的鼓组。
从第七小节接着听:这段鼓花把下一轮带起来了吗?
播放原版,再切到课程包的鼓花参考版。勾选“只循环最后四秒”,跟着旋律数到第八小节第三拍。原来是一下底鼓接一下军鼓,改编后四下军鼓越来越重。再听一轮,决定你想保留这个力度变化,还是让最后一击轻一些。
正在加载音频……
你来判断 从第七小节回放,跟着数最后两拍。四下军鼓应逐渐变强,下一轮的第一拍仍然落在原来的位置。
第五讲
把 8 小节扩成 32 小节:低音、减法、鼓花各放在哪
- 目标
- 按参考曲的段落结构,把八小节扩成三十二小节;用生成模型找配器思路
- 产出
- 我的三十二小节.mid 和导出的 WAV,每段配一句制作意图
第 2 讲你分析过一首参考曲的段落:哪里进鼓、哪里低音变密、哪段旋律重现。扩写时就照它的结构安排自己的四段,参考曲当蓝本,自己的动机当材料。
把参考曲的段落变化,翻译成自己四段的做法
这张对照表就是你的编曲蓝本:参考曲提供“在哪里变、怎么变”,你的动机提供材料。改到你认可为止,再往下做。
先给四段各写一句要做什么
把八小节原样复制四次,就有了三十二小节,但听众未必知道哪里是新段落。先给每段写一句制作意图:
三十二小节参考.mid 的结构,可以直接播放。这是其中一种对法,你的四段按自己的对照表来。深色小格是鼓花所在的小节。本例只在第 32 小节放鼓花,用它提示“要循环了”;同一种鼓花用得越少,提示作用越明显。能说清每段发生了什么,Agent 才能替你做具体修改,听众也才有机会听出结构。
先让 DSH 按四句意图搭出第一版 32 小节
先有一版能听的 32 小节,再逐段细调低音、减法和鼓花。
制作意图由你写,执行可以交给 Agent,好不好听由你判断:
做完和课程包里的 三十二小节参考.wav 放进第 3 讲的播放器 A/B 对比。
第 9–16 小节加低音:C 和 E 作低音,听感不同
第一段暂时只留旋律和基本鼓点。第二段加入低音:先在每小节第一拍放一个能支撑旋律的低音,拉长来听。
第一小节的 C、E、G 提示了 C 和弦。用 C 作低音,起点很稳;换成 E 作低音,和弦音相同,下方的走向不同。第二小节旋律是 D、F、A,可以试 D 作低音。两小节连起来听,选择你想要的低音运动。单看某一拍上有哪些音,决定不了整首的和声。
从 C–E–G 到 D–F–A:三个声部一起上行,还是换个排列
C–E–G 到 D–F–A,三个声部同时上行一级,平行感很明显(参考编排用的就是这种连接,听第 9–10 小节)。其中 C–G 到 D–A 是一组平行五度:四部和声里要避免,流行编配里常见,参考编排故意保留了它。试试把第二个和弦换成转位,比如 A–D–F 或 F–A–D,让部分声部下行或保持不动,色彩和重心都会变。一次只调和弦声部:固定低音和鼓,听旋律有没有被中间声部挤住。可以让 Agent 列出两种和弦排列;每次都保留原始 MIDI,方便把喜欢的改动拿回来。
第 17–24 小节:去掉部分底鼓,拉长旋律
保持原速度,拿掉部分底鼓落点,把旋律的结尾拉长。速度数值没变,听感空出了更多位置。
第 25–32 小节:带回原节奏,鼓花只放在第 32 小节
第四段带回最初的节奏型,用最后一小节的鼓花提示段落即将循环。如果每两小节都加同样的鼓花,这个声音就不再能提示转折。判断一处改动是否有效,要连同前后二到四小节一起听,看它在段落里有没有起作用。
微调时一次只改一样:起点、力度或音色
把伴奏轨上一对相邻八分音符中的第二颗稍微往后挪,试听后再决定是否保留;同时检查音尾有没有和下一拍重叠。量化把起点拉向网格,力度调整改变轻重,两者可以分开使用。不要一次同时改起点、力度、音色和混响,否则听到变好了,也不知道该保留哪一步。
卡住时,让生成模型给你一个更稀疏的第三段思路
有了一版能逐音修改的作品,可以让 Suno 这类生成工具提供另一种音乐思路。在它的风格描述栏里把问题限定住:
听结果时只围绕“有没有给主旋律留出空间”评判,具体看三点:乐器密度、低音节奏、哪里抢了主旋律。如果生成结果连速度和曲长都不对,就把最有价值的一处配器思路记下来,回到自己的工程里实现。即使输出没法直接拼进工程,也能变成一个制作决策。只把你认可的一处配器思路写回 我的三十二小节.mid 的第三段。
作业:四段工程,每段配一句话
提交 MIDI、导出的 WAV,再给每段配一句具体描述,例如:“第三段保留军鼓,去掉第三拍底鼓,旋律尾音延长一拍。”
你来判断 先合上轨道表听一遍。记下哪一段开始变厚、哪一段退下来,再对照当初写的四句话。
第六讲
把你的 32 小节出成乐谱:核对拍数和反复,再渲染一版伴奏
- 目标
- 把 我的三十二小节 转成能给乐手看的谱,读顺节奏和反复,渲染出给第 7 讲配人声用的伴奏
- 产出
- 我的三十二小节.musicxml 和 PDF,钢琴预览版、弦乐伴奏版两份音频
作品扩写好了,下一步是出谱:给乐手看、给自己存档,也方便检查节奏和反复。先用课程包的练习谱熟悉流程,再导出你在第 5 讲做好的 我的三十二小节.mid。
本讲用什么:MuseScore 读谱和渲染,DSH 做检查和批量导出
用免费的 MuseScore 打开和渲染乐谱。可以交给 DSH 的是:检查 MusicXML 的拍号、小节数和声部是否与原谱一致,以及批量导出两版音频。读谱和听辨由你完成。课程包的 乐谱/ 里有两份练习谱:
| 文件 | 内容 |
|---|---|
八小节练习.musicxml | 旋律 + 低音两个声部,4/4,速度 120,8 小节 |
八小节练习-前四小节反复.musicxml | 同一份谱,第 1–4 小节加了反复记号:谱面 8 小节,实际演奏 12 小节 |
它应该报告:两个声部都是 4/4;谱面 8 小节,展开后 12 小节;谱面第 5 小节在演奏中是第 9 小节。读 MusicXML 它多半会请求安装 music21(处理乐谱的常用库),可以允许。
打开 MusicXML 看一眼:第 1 小节的第一个音是这样写的
MusicXML 是纯文本,用任何文本编辑器都能打开。下面摘自 乐谱/八小节练习.musicxml 第 1 小节,右边是每一行的意思:
<measure number="1">第 1 小节开始<divisions>1</divisions>一个四分音符记作 1 个时间单位<time><beats>4</beats><beat-type>4</beat-type></time>拍号 4/4<clef><sign>G</sign><line>2</line></clef>高音谱号(G 谱号在第二线)<sound tempo="120"/>播放速度 120<note><pitch><step>C</step><octave>4</octave></pitch>一个音:C4(中央 C)<duration>1</duration><type>quarter</type></note>时值 1 个单位,记成四分音符对比 MIDI:MIDI 只记“60 号键在第 0 tick 按下、第 480 tick 松开”;MusicXML 记的是“C4、四分音符、在第 1 小节、高音谱号”。所以转谱、移调、检查拍号时,让 Agent 读 MusicXML 更可靠。
把两份乐谱渲染成音频
按 120 BPM 播放,普通版约 16 秒,反复版约 24 秒。在反复版第 8 秒附近听,应该能认出开头的旋律又回来了。
MusicXML、MIDI、PDF 各存了什么
| 格式 | 记录什么 | 适合做什么 |
|---|---|---|
| MusicXML / MXL | 小节、声部、音符、休止,以及部分歌词和记谱信息 | 制谱、交换乐谱 |
| MIDI | 演奏事件 | 渲染、编辑演奏 |
| 一页可阅读的谱面 | 阅读;扫描页需要识别并人工校对,才能得到可靠的结构化音符 |
PDF 识别错一个附点音符,后面整句都可能挪位。这时先在谱面上边数边唱、修正拍数,远比混音时挪整条轨有效。
导入后先修拍号和分句,定下速度
MIDI 转成乐谱时,同一个长音可能被写成跨拍连音,休止和声部拆分也可能和你自己的写法不同。这一轮的任务是把谱读顺,并确认渲染出来的节奏符合原意。原稿没有速度时,现在就设定速度,不要等人声导入以后再决定整首多快。
把你的 32 小节转成乐谱
前面用练习谱学会了读 MusicXML、看反复展开;从这一节起,操作对象换成你自己的作品。
第一遍用一种乐器渲染,查休止、反复和移调
用一种清楚的乐器渲染主旋律,检查三件事:
- 句子:换气处有没有休止,连音有没有提前断开。
- 反复:如果前四小节反复一遍,谱面上的第 5 小节在声音里已经晚了四小节。记下实际演奏顺序,后面人声要跟着展开后的伴奏走。
- 移调乐器:核对记谱音高和实际听到的音高,尤其留意做过一次移调、导入时又移了一次的情况。
第二遍换音色;旋律被盖住,先挪伴奏
同一段旋律分别用钢琴和持续音色试。钢琴起音明显;持续音色更容易暴露音符之间的断口。先独奏,听句子是否连贯;再打开伴奏,看两轨是否在争同一个音区。旋律被盖住时,先把伴奏的声部移开、缩短某个铺底音,再决定要不要提高旋律音量。
请同学听出两版的配器差别
基础预览和配器版用相同的起点和速度导出。把两份音频交给同学,请对方指出哪个声部换了音色、哪一句的演奏法变了。对方指得出来,说明配器的变化确实听得见。
你来判断 跟谱听反复位置,再闭眼听两版配器。哪一版能让你从头跟唱旋律?指出遮住旋律的具体小节交给 Agent 再改。
第三部分 · 做出声音
加上歌声,导出能交给别人的版本
给作品加一句人声,再把要交出去的版本截好、统一响度、转好格式。
第七讲
用歌声合成唱出“夜风入窗”,再改成“晚风入窗”
- 目标
- 先唱清一句话,再扩展到整首;能局部修改并重新导出
- 产出
- 人声干声、伴奏、混合版三份音频
第 6 讲你有了 我的三十二小节 的伴奏。这一讲给它的第一句旋律配上人声:先用第一小节四个音练清“一个字怎么唱”,再把歌词铺到你自己的第 1–8 小节。
先让“夜风入窗”四个字唱清楚
取第一小节 C、E、G、E,每个音一拍,临时填上四个字:“夜、风、入、窗”。把旋律导入已有目标语言声库的歌声编辑器,例如 Synthesizer V(有免费的 Basic 版和部分免费的 Lite 声库),或免费的 OpenUtau(社区有中文声库)。Synthesizer V 用“文件 › 导入”打开 MIDI;OpenUtau 直接把 MIDI 拖进窗口。先听默认结果,记下最影响理解的那个字。歌声合成要同时处理音符、歌词、发音和时间,第一遍的目标只是听清这句话。
准备素材这一步可以交给 DSH:
“窗”跨两个音:第二个音写延音,不要再写一次“窗”
把“窗”延长到下一拍,再把延长的部分改成另一个音高。这时同一个字跨了两个音,后一个音应该延续前一个字的元音:
用当前声库支持的连音或延音方式。回放时特别听第二个音开头是否多出一次咬字,再检查“入”的起音有没有挤掉“风”的尾部。一次只改一个字,才能分辨问题出在发音词典、音符时值还是音素时序。
句尾留休止,重音字给足元音长度
- 句尾先留一个短休止,听句子有没有落点,再考虑要不要加明显的吸气声。
- 多音字先按整句语义决定读音,再修正发音。
- 长音先对齐音高和时值,再少量调整力度和音高曲线。
- 每个字都加同样深的滑音,装饰会盖过语言重音。把歌词念一遍,找到自然会强调的字,先让它有足够的元音长度和力度。
把歌词铺到你自己的第 1–8 小节
导出干声、伴奏、混合版,检查有没有对齐
从同一个工程起点导出三份:人声干声、伴奏、两者的混合版。干声里不要先加混响,以后换空间感才方便。放回 DAW,先对第一句,再对最后一句:
- 整首都晚相同的时间:检查导出起点和前导空白。
- 前面对齐、越往后越偏:检查速度图、反复展开和音频时长。
两种现象指向不同的原因,不要急着把每个字手工拖一遍。
把“夜”改成“晚”,只重导这一句
把“夜风入窗”改成“晚风入窗”,只重做这一句并重新导出,再检查其他句子没有跟着变化。工程能这样局部修改,后面才好继续制作。
你来判断 独听干声里“窗”的起音和拖腔,再放混合版。一个字跨两个音时,应能听到音高变化和连续的元音。
第八讲
用 FFmpeg 截片段、对齐响度,把你的 Demo 打包交付
- 目标
- 准确截取指定小节;每次比较只回答一个问题
- 产出
- A、B 末两小节片段,一个淡出版,一个 MP3 副本
作品要交给别人听之前,还有一道工序:截出要对比的片段、统一响度、转成合适的格式。先拿第 4 讲的两版八小节练手,再把第 7 讲的混合版打包交出去。
第 7 小节从 12 秒开始,不是 14 秒
小节编号从 1 开始,音频时间从 0 开始。120 BPM、4/4 拍时,第 n 小节的起点是 (n − 1) × 2 秒。直接用“7 × 2”会得到 14 秒,那是第 8 小节的起点,这是最常见的错一小节。用下面的换算器试几个位置:
剪出同一段,做一个淡出版本
三段都从同一拍开始,长度应相同。先听 A 的两个尾音,再听 A、B 最后一秒的军鼓。
A 对淡出版听尾音,A 对 B 听鼓的密度
- A 对比 A淡出:听尾音消失的速度。淡出只改变音量包络,四拍的落点仍在原处。
- A 对比 B:听最后一秒的事件密度。
两组看起来都是“听两个文件”,回答的却是不同的问题。分析之前先决定这次听什么,才不会把所有变化都归成“更有感觉”。
转成 MP3 丢掉的信息,转回 WAV 也回不来
WAV 里的 PCM 样本适合反复编辑;MP3 通过舍弃一部分信息换取更小的体积。把 MP3 转回 WAV 能得到可编辑的 PCM 文件,但编码时丢掉的信息不会因此恢复。这个例子导出的 MP3 时长约 4.075 秒,比原片段略长,因为 MP3 编码会在首尾补少量帧。做精确对齐时用 WAV,给别人快速试听时再导出压缩副本。
把两版音量调近,再听鼓的轻重
瞬间最响的一下和整段听起来多响,是两个问题。鼓的短促峰值很高;一段持续铺底的合成器峰值可能更低,听起来却更满。如果 B 整体更响,再问“哪版更有冲击力”,答案里就混进了音量差。先把两版的响度调到接近,再听军鼓进入得是否合适、尾音是否盖住下一段。
在 Agent 返回的测量结果里,I 表示整段的综合响度。
  Integrated loudness:
    I:         -22.1 LUFS      ← 看这一行
    Threshold: -32.1 LUFS
课程包里 A、B 两段分别是 −22.1 和 −21.6 LUFS,B 多了四下军鼓,响 0.5 LU。相差在 1 LU 以内可以直接比;更大时,让 Agent 把较响的一版调低,再回听。
节拍分析也一样。软件可能把 120 BPM 估成 60,两拍并成一拍也能对得上。把数值放回拍号和乐句里判断,它才有音乐含义。
查看原帖的两张配图


把你的 Demo 打包交付
交付包里每个文件都要能说清是什么:文件名带版本和日期,附一份对照表。对方拿到不用问你就能听、能接着改。
你来判断 把两版从同一拍开始放,先听片尾有没有自然收住,再听军鼓变密的位置。选出你愿意留在工程里的一版。
第四部分 · 复用
把常用做法存成工具,完成结课演示
前面反复做过的事,写成 Skill 和 MCP 工具,下次一句话就能调用。最后把整条线演示一遍。
第九讲
把读 WAV 封装成 MCP 工具、把 A/B 导出写成 Skill,再把整条线演示一遍
- 目标
- 把常用动作封装成 MCP 工具和 Skill;完成结课演示
- 产出
- 一个能用的 MCP 工具、一份 Skill、一次结课演示
第 4 讲比鼓花、第 5 讲比低音、第 8 讲截片段,你已经三次让 Agent“从同一拍导出两版对比”,每次都要重新交代速度、范围和核对方式。这一讲把它写成 Skill,把查 WAV 参数写成 MCP 工具。
把“读 WAV 时长”封装成 MCP 工具,用三种输入测
回到基础篇的 MCP:想让不同的助手都能调用“查音频时长”,就把它按 MCP 的约定封装一次。工具本身仍然要读文件、校验输入,失败时报告原因。第一次只做一个小动作:读 WAV,返回秒数、采样率和声道数。课程包的 工具/wav_info_mcp.py 是参考实现,只用 Python 标准库。核心逻辑如下(为了好读做了简化:实际返回还多 frames、bit_depth 两项,报错信息也更详细):
def wav_info(path):
    if not os.path.exists(path):
        return True, f"找不到文件:{path}。请检查文件名和工作目录。"
    try:
        with wave.open(path, "rb") as w:
            sr, ch, n = w.getframerate(), w.getnchannels(), w.getnframes()
    except wave.Error as e:
        return True, f"不是有效的 PCM WAV:{path}({e})。"
    return False, json.dumps({"seconds": n / sr, "sample_rate": sr, "channels": ch})
其余代码负责 MCP 的握手:告诉 Harness“我有一个叫 wav_info 的工具,需要一个 path 参数”,再把结果按约定格式送回去。注册步骤由 Agent 按当前 Harness 完成。下面是它写入的配置示例:
{ "mcpServers": { "wav-info": { "command": "python3", "args": ["工具/wav_info_mcp.py"] } } }用三种输入各测一次。下面是用官方 MCP Python SDK 作为客户端实际调用得到的返回:
| 输入 | 返回 |
|---|---|
八小节试听.wav | 成功:{"seconds": 16.0, "sample_rate": 22050, "channels": 1, "frames": 352800, "bit_depth": 16} |
不存在.wav | 错误:找不到文件:不存在.wav(解析为 …/不存在.wav)。请检查文件名和工作目录。 |
内容是“这不是音频”的 假的.wav | 错误:不是有效的 PCM WAV(file does not start with RIFF id)。可能是改了后缀的其他文件,或是浮点 / 压缩编码的 WAV。 |
出错时返回的不只是“失败”,而是原因和下一步该查什么。调用方据此判断该继续,还是交给人处理。
写一份“导出两版供试听”的 Skill,让别组照着做
课程包的 工具/skills/export-ab-preview/ 是参考答案:SKILL.md 写清四件事(输入和版本名、相同的起止小节、输出格式、导出后怎么核对),export_ab.py 把固定动作做成脚本。交给 Agent 执行后,你可以直接试听导出文件。
实际输出:
范围:第7-8小节,起点 12.000 秒,时长 4.000 秒(120 BPM,每小节 4 拍)

核对:
  ✓ A_第7-8小节.wav:4.000 秒(应为 4.000),22050 Hz,1 声道
    A_第7-8小节.mp3:4.075 秒(MP3 编码器会在首尾补少量帧,略长属正常)
  ✓ B_第7-8小节.wav:4.000 秒(应为 4.000),22050 Hz,1 声道
    B_第7-8小节.mp3:4.075 秒(MP3 编码器会在首尾补少量帧,略长属正常)
  ✓ 两版采样率与声道数相同
让 Agent 把这个文件夹放进 Harness 的 Skill 目录(Claude Code 是项目里的 .claude/skills/),以后说一句“把 A 和 B 的第 7–8 小节导出来给同学听”,Agent 就会按这份说明先确认缺的条件,再调用脚本。导出的四个文件在 试听导出/ 文件夹里。检验方法:让下一组同学只拿新素材和这份说明,看能否独立导出起点一致、命名清晰的 A/B。做不到,就说明里漏了关键条件。自学时可以新开一个会话,只说一句“把 A 和 B 的第 7–8 小节导出来给同学听”,看它会不会先问速度和小节范围。
结课演示:听、写、做声音、复用,各演示一件
| 来自 | 演示内容 |
|---|---|
| 听 | 在你的播放器里打开参考曲,按数字键跳到你修订过的段落,说出它在这里做了什么 |
| 写 | 播放 我的三十二小节,指出哪一段借用了参考曲的哪处变化,再打开 MuseScore 谱面对照 |
| 做声音 | 播放 交付/ 里的混合版,单独给出干声和伴奏,现场把一句歌词改掉重新导出 |
| 复用 | 用这一讲的 Skill 一句话导出两版对比 |
听众既能听到作品,也能看到你怎样把一个目标交给 Agent、怎样判断它做好了、结果不合预期时怎样继续修改。
你来判断 把导出的两版从同一拍放起,听鼓花和人声改词,再打开对应的可编辑工程,确认能接着改。
换一款 Harness 也能复用:四款工具的 Skill 和 MCP 放在哪
手上有三件活。选一件,看看要把什么交给 Agent,以及最后打开什么来验收。
Codex / Claude Code 打开播放器项目,把这次切歌动作作为重现步骤。看修改了哪行代码,再点一次听。
12.0 秒 → 16.0 秒 两小节,四秒钟。
DSH 给它 A 和 B 两份 WAV,让它从同一拍截取。把成品排进同一个队列,检查两段是不是都从第七小节开始。
“主唱进来时,钢琴右手盖住了第一个字。”
↓主歌第一句 减轻钢琴右手力度,再听一次咬字。
WorkBuddy 选中排练笔记所在的文件夹,让它按曲目归纳修改意见。点回原文,检查“右手”有没有被误写成“整轨”。
查看四款工具的 Skill、MCP 和配置入口
| 工具 | 拿什么来练 | 到哪里看结果 |
|---|---|---|
| Codex | 打开播放器项目,让它修“切换下一首时进度没有归零”。先写出重现步骤,再让它改代码。 | 查看文件差异,运行播放器试切歌。项目 Skill 放在 .agents/skills/;终端运行 codex mcp list 可列出已配置的 MCP 服务。 |
| Claude Code | 在课程目录打开终端,运行 claude。让它读导出脚本,解释第七小节为什么从 12 秒开始。 | 展开命令与返回值。课程组共用的 Skill 放在 .claude/skills/,项目 MCP 配置可放在根目录的 .mcp.json。 |
| DeepSeek Harness(DSH) | 跟第二讲分析录音,再用同一个工作目录做第三讲的播放器。本课的参考播放器就是用 DSH 写的。 | 看会话里的工具调用,再打开生成的文件。文件系统 Skill 插件会扫描项目的 .dsh/skills/;MCP 客户端插件按服务逐个配置。 |
| WorkBuddy | 在桌面工作台选演出笔记所在的文件夹,让它按曲目整理排练意见,每条附原文件名。 | 挑一条意见回原文核对。在“专家·技能·连接器”里查看已安装技能;MCP 也有图形配置入口。 |
第一次做播放器,用 DSH 可以直接对照本课成品。已经在用 Codex 或 Claude Code 的同学,可以沿用自己的工具;要交的仍是能切歌的网页。做选读 B 的资料整理,如果平时主要用桌面软件,WorkBuddy 的文件夹工作区也适合这项练习。
配置参考:Codex 的 MCP 配置 · Claude Code 项目配置 · DSH 技能目录 · DSH 的 MCP 客户端 · WorkBuddy 连接器
选读
让 Agent 操作 DAW;查文献、整理笔记;在本机跑 YuE2
这三讲不在制作主线上,按需要选读。
选读 A
让 Agent 用鼠标键盘,在 DAW 里改出这四下军鼓
- 目标
- 让 Agent 通过界面完成鼓花修改,并分别验证界面、保存和声音
- 产出
- 重开后仍保留改动的 B 工程,以及从同一起点导出的 A/B 音频
第 5 讲已经写出了三十二小节。现在回到八小节的鼓轨副本,把第 4 讲你亲手做过的修改交给 Agent。这样,你熟悉每一步在 DAW 里应该选中什么,也听得出最后两拍的变化。
先另存 B 工程,让轨道名、标尺、播放头都在屏幕上
回到八小节原工程,先另存为 B。把软件窗口调到能看见轨道名、小节标尺和播放头的状态。
Computer use 是一类特殊的工具:截屏、移动鼠标、点击、按键。Agent 可能看得见“鼓”这个轨道名,却不知道点击后选中的是整条轨道、一段区域还是一颗音符。选择范围决定了下一次删除或移动的对象,所以每一步之前,先确认编辑器里的选中状态。
给它看屏幕、点鼠标的权限,在副本上操作
- Mac:系统设置 › 隐私与安全性,在“辅助功能”和“屏幕录制”(新系统里叫“屏幕与系统音频录制”)里,给运行 Agent 的程序打勾,否则它看不到屏幕、点不了鼠标。
- 只在 B 工程副本上操作,关掉其他工程和不相关的窗口。
- 先让它定位到目标小节,你确认选区;同一处编辑可让它连续完成。
把这句话发给 Agent
怎么确认它点中的是第 8 小节第 3 拍
- 改前:第 3 拍底鼓,第 4 拍军鼓。
- 改后:四颗等间隔的军鼓(对照第 4 讲的鼓点图:图中画的是第 7–8 小节,下两行是 B 版)。
- 编辑器只显示时间时,用 15 秒作为第二个定位依据。
- 整段区域仍处于高亮时,先进入区域内部,再选音符。
- 八度编号各软件不同:Logic 和 Cubase 默认把中央 C(MIDI 60)叫 C3,所以军鼓 38 显示为 D1;也可以直接点键试听。在 Logic 里双击区域,就进入钢琴卷帘。
让它撤销一步,并说清撤销了什么
让 Agent 先回放,再撤销最后一个动作,并说明撤销了什么。有的软件把插入音符、移动音符和修改力度分开记录,撤销一次可能只还原最后一颗音的力度。查看历史或逐步撤销,直到两颗原音恢复,再重做一遍并重新检查。
改完查三处:界面、重开后的工程、导出的声音
| 层面 | 怎么验证 | 只验这一层会漏掉什么 |
|---|---|---|
| 当前界面 | 钢琴卷帘里四颗军鼓的位置和力度正确 | 没保存,重开就没了 |
| 持久保存 | 保存、关闭、重开 B,改动仍在 | 音符对了,鼓组或路由错了 |
| 实际声音 | A、B 从相同起点导出,在播放器里与参考答案对照 | — |
建轨道、导素材用模板或脚本;改音符留给界面
固定动作不必让 Agent 逐个点对话框:在 Logic 和 Cubase 里可以先做一个建好轨道、设好速度的模板工程;REAPER 还能用 ReaScript 脚本建轨、导入素材。把钢琴卷帘留给局部修改。作业要求的是工程能重开、指定位置的改变听得出来。
你来判断 重开 B 工程,独奏鼓轨听末两拍,再与 A 对照。既要能听出改动,也要能回到可继续编辑的工程。
选读 B
让 Agent 整理文献,把每条笔记连回原文
- 目标
- 让 Agent 帮你查文献、整理学习资料,并且能核对它交上来的每一条
- 产出
- 一张带出处的文献摘录表,一份核对报告,一份标了出处的复习手册
做研究分五步:你定问题、最后核对,中间三步交给 Agent
开始前先问它一句:“你现在能联网搜索和打开网页吗?”不能的话,这一讲的检索部分先不要做,否则它只能凭记忆写,而凭记忆写正是编造的来源。它说“能”时,用一句话验证:
贴回来的和下面表格里 MusicLM 那句一致,才算真的能联网。
把论文、结论和原文段落排在同一行
一段流畅的综述读起来像真的,但没法核对。一张表每一行都能单独检查。合格的一行应该长这样(摘录是 arXiv 上 MusicLM 摘要的第一句,原样复制):
| id | title | year | 原文摘录 | 一句话概括 |
|---|---|---|---|---|
arXiv:2301.11325 | MusicLM: Generating Music From Text | 2023 | 「We introduce MusicLM, a model generating high-fidelity music from text descriptions such as "a calming violin melody backed by a distorted guitar riff".」 | 用文字描述生成高保真音乐的模型。 |
“原文摘录”这一列最重要:它要求 Agent 真的打开过原文。只有概括、没有引句的行,先当作没核对过。
用 DOI 和 arXiv 编号找回论文
Agent 可能把标题记错、把年份记错,甚至编出一篇不存在的论文,而且写得和真的一样。课程包的 工具/check_refs.py 拿每一条的 DOI 或 arXiv 编号去官方登记处查(DOI 查 Crossref,查不到再查 DataCite;arXiv 编号查 arXiv),比对标题和年份。研究与整理/参考文献示例.csv 是一张练习表,里面混了三条有问题的引用:
实际输出:
1. ✓ arXiv:2301.11325  MusicLM: Generating Music From Text(2023)
2. ✓ arXiv:2005.00341  Jukebox: A Generative Model for Music(2020)
3. ✓ doi:10.25080/Majora-7b98e3ed-003  librosa: Audio and Music Signal Analysis in Python(2015)
4. ✗ arXiv:1809.04281  Music Transformer(2019)
     年份不符:记录里是 2018(预印本年份和正式发表年份可能不同,需要人判断)
5. ✗ arXiv:2005.00341  Jukebox: Neural Audio Synthesis at Scale(2020)
     标题不符:记录里是《Jukebox: A Generative Model for Music》
6. ✗ 查不到这个编号  doi:10.5555/fake-music-eval-2024(声称:A Listening Test Protocol for AI-Generated Music)——可能是编造的引用

共 6 条,3 条一致,3 条需要人工处理。
打开报告里的一条不一致记录,用 DOI 进入原文,对照题名和发表年份,再决定怎样修改参考文献。
用 Excel 直接双击中文 CSV 可能乱码:改用“数据 › 从文本/CSV”导入并选 UTF-8,或者用 Numbers 打开。
| 标记 | 说明什么 | 你怎么处理 |
|---|---|---|
| ✓ 一致 | 编号存在,标题、年份对得上 | 还要打开原文,确认摘录真的出自这篇 |
| ✗ 年份不符 | 可能记错,也可能一个是预印本年份、一个是正式发表年份(第 4 条就是:arXiv 2018 年,会议 2019 年) | 按你引用的版本统一年份 |
| ✗ 标题不符 | 可能是标题记错、只写了半个标题,也可能是编号填错、指向了另一篇(第 5 条是编号对、标题编错) | 先用标题去搜,确认你要引的是哪一篇,再改错的那一项 |
| ✗ 查不到 | Crossref 和 DataCite 里都没有这个编号,很可能是编造的引用 | 让 Agent 说明这条从哪里来;说不清就删掉 |
| ? 暂时查不了 | 查询请求未完成 | 过一会儿重跑 |
| ✗ 编号格式不对 | 编号没以 doi: 或 arXiv: 开头 | 改成这两种写法再跑 |
脚本只能证明“这篇论文存在、标题年份对得上”,证明不了“论文里真的这么说”。所以 ✓ 的那些,也要抽查摘录。
整理学习资料:每一条都要标来源文件和行号
研究与整理/和声课笔记/ 里是三周的和声课笔记。它们和真实笔记一样:有的内容在几周里重复出现,还有一处写错了。
合格的手册应该包含下面这样的内容(节选):
## 转位
- 第一转位(六和弦):三音在低音。〔第2周_转位与声部进行.md:6〕〔第3周_属七和弦.md:10〕
- 第二转位(四六和弦):五音在低音。〔第2周_转位与声部进行.md:7〕〔第3周_属七和弦.md:11〕

## 待核对
- C 大调 vii 级和弦的性质,两处说法不一致:
  “vii°:B–D–F(减)”〔第1周_三和弦.md:17〕
  “vii 级是小三和弦:B–D–F。”〔第2周_转位与声部进行.md:12〕
B–D–F 是两个小三度,根音到五音是减五度,所以是减三和弦,第 2 周那一行写错了。Agent 应该把这处矛盾列出来,交给你判断,而不是悄悄选一个写进手册。拿到手册后检查三件事:
- 随手挑几条,按出处打开原文件,看那一行是不是真的这么写。
- “待核对”一节有没有列出 vii 级的矛盾。没列出来,说明它没有仔细比对。
- 练习题考的内容,笔记里是不是都有。
把做法写成 Skill,下学期直接复用
上面这套要求(标出处、合并重复、矛盾不自己选、交付前自查)每次都要重新交代。课程包的 工具/skills/study-handbook/SKILL.md 把它写成了一份 Skill。把 study-handbook 这个文件夹放进 Harness 的 Skill 目录(DSH 是项目里的 .dsh/skills/,Claude Code 是 .claude/skills/)后,下次只要说“把这学期的笔记整理成复习手册”就行。Skill 怎么写,在第九讲。
你来判断 随机选一条笔记或引文,顺着链接、页码或行号回到原文,判断原文是否真支持那句话。
选读 C
在本机跑开源的 YuE2:用官方 Skill 生成一段伴奏
- 适合
- 有一台带 24 GB 显存 NVIDIA 显卡的 Linux 电脑,想把开源歌曲生成模型跑起来的同学
- 产出
- 一段 YuE2 生成的伴奏,一份能复现这次生成的记录
YuE2 是什么,需要什么机器
YuE2 是 M-A-P 团队开源的歌曲生成模型(代码在 GitHub 的 multimodal-art-projection/YuE,模型是 Hugging Face 上的 m-a-p/YuE2-3B),能根据风格描述和歌词生成带人声的整首歌,也能先规划旋律与和弦再生成。它和 Suno 属于同一类模型,区别是权重公开,可以在自己的电脑上跑。
| 系统 | Linux,Python 3.12 |
| 显卡 | 支持 BF16 的 NVIDIA 显卡,24 GB 显存;每张卡一次跑一个任务 |
| 模型文件 | 第一次运行时自动从 Hugging Face 下载 |
| 授权 | 代码 Apache 2.0;模型权重 CC BY-NC 4.0,个人创作免费使用,公司商用向官方申请授权 |
先让 DSH 检查这台电脑够不够
显存不够 24 GB 的电脑跑不动默认设置,这一讲读到这里就够了,生成模型的原理在 B1 已经讲过。
用官方 Skill 让 Agent 跑 YuE2
YuE2 的仓库自带一份 Skill(skills/yue2-music),写好了安装、生成、试听的步骤:安装运行环境用 python -m pip install git+https://github.com/multimodal-art-projection/YuE.git,生成用 scripts/run_yue2.py generate,scripts/listen.py 会生成一个本地试听页。把它装进 DSH,Agent 就照着做:
第一次运行要下载模型,时间主要花在这里。之后每次生成,Agent 都会按 Skill 写好的命令执行,你只需要描述想要的音乐。
把这次生成记下来,下次只改一个条件
| 机器 | 显卡型号、显存 |
| 版本 | YuE2 运行时版本、模型与解码器版本 |
| 输入 | 风格描述、歌词、是否先规划旋律与和弦 |
| 输出 | 音频时长、文件位置 |
| 资源 | 生成耗时、显存峰值 |
把参数和成品一起放进作品目录。下一次只改一个条件,例如减少打击乐密度。比较两次输出时,写明哪些条件保持一致、哪些由模型自由决定,才知道这次尝试给制作带来了什么。听到喜欢的配器思路,像第 5 讲那样,只把那一处写回 我的三十二小节.mid。